瑞萨RA8系列AI MCU重塑下一代边缘智能
近年来,人工智能正以前所未有的速度从云端“下沉”到终端设备。从智能家居的语音交互,到工业电机的预测性维护,再到可穿戴设备的健康监测——AI的触角已无处不在。在这一浪潮中,两个关键硬件概念日益凸显:NPU(神经网络处理单元)和AI MCU(微控制器单元)。
如果说NPU是专为AI计算而生的“特种兵”,那么AI MCU则是集成了这种“特种兵”能力、同时兼顾传统控制与低功耗特性的“全能战士”。本文将深入探讨NPU是什么、AI MCU为何成为新风口,并全面剖析瑞萨电子在这一领域的战略布局与产品矩阵,为开发者与产业界提供一份深度参考。
一、NPU是什么?为何是AI计算的“专用引擎”?
1.1 NPU的定义与核心价值
NPU,全称Neural Processing Unit(神经网络处理单元),是一种专门为加速人工智能算法,尤其是深度学习神经网络(如卷积神经网络CNN、循环神经网络RNN)而设计的处理器。
与通用CPU(擅长复杂逻辑和任务调度)和GPU(擅长大规模并行浮点运算)不同,NPU从架构层面针对神经网络中大量的乘积累加(MAC)运算和数据复用模式进行了极致优化。其核心价值在于:
超高能效比:执行相同的AI推理任务,NPU的功耗远低于通用处理器。以瑞萨RA8P1为例,其集成的Ethos-U55 NPU在AI推理场景下的能效表现远超单纯依赖CPU内核的方案。这对于电池供电的物联网设备至关重要。
超低延迟:专用硬件流水线和内存架构大幅降低推理时延,满足工业控制等场景的实时性要求。
面积效率高:在同等芯片面积下,NPU能提供远超通用处理器的AI算力(TOPS/Watt指标优异)。
1.2 NPU的典型架构特点
一个典型的NPU内部通常包含:
张量处理单元阵列:执行核心的矩阵/向量运算
片上高速缓存与内存:减少对外部存储的访问,满足高数据吞吐需求
专用数据调度器与控制器:高效管理数据流和计算任务
正是这些特点,使得NPU成为在终端设备上实现实时、高效AI推理的不二之选。
1.3 NPU vs CPU:
AI推理的能效革命
以瑞萨RA8P1MCU为例,其集成的Arm Ethos-U55 NPU相比仅使用Cortex-M85 CPU执行相同神经网络模型,在典型AI/ML应用场景下,最高可实现35倍的推理性能提升。
这种提升并非简单的“堆料”,而是源于NPU在架构层面的根本性优化——从数据搬运路径到计算流水线,每一个环节都为神经网络计算而量身设计。
二、AI MCU为何越来越火?边缘智能的必然选择
2.1 从云端到边缘:
AI的范式转移
过去,AI处理主要发生在云端:终端设备采集数据,发送到云端进行推理,结果再返回终端。这种方式不仅依赖网络,还存在延迟和数据隐私风险。
如今,一场深刻的范式转移正在发生:AI推理正从云端向边缘设备迁移。边缘AI带来实时响应、数据隐私保护、降低延迟、减少带宽成本等显著优势。
2.2 AI MCU爆火的驱动因素
数据隐私与安全:边缘计算无需将敏感数据上传至云端,在本地即可完成处理,符合日益严格的数据法规要求。
网络依赖与实时性:在网络不稳定或无网络的场景(如工厂车间、偏远地区),本地AI推理保证系统的可靠性与实时响应。
带宽与成本:避免海量原始数据(如振动波形、音频流)上传带来的带宽压力和云服务成本。
功耗约束:对于始终在线的感知设备(如智能门锁、可穿戴设备),极低功耗的AI MCU是唯一可行的方案。
应用场景爆发:从关键词唤醒、异常检测到预测性维护,碎片化且海量的边缘场景催生了标准化、易用的AI硬件平台需求。
2.3 “用MCU的功耗,
实现近SoC的智能”
AI MCU的本质,是将NPU或类似的AI加速器以IP核的形式,与MCU的CPU、内存、外设等集成在同一颗芯片上。它并非简单拼接,而是从系统级进行协同设计,实现了1+1>2的效果。
AI MCU正在成为智能终端设备的“新大脑”——它让每一台设备都具备了本地、实时、低功耗的决策能力。
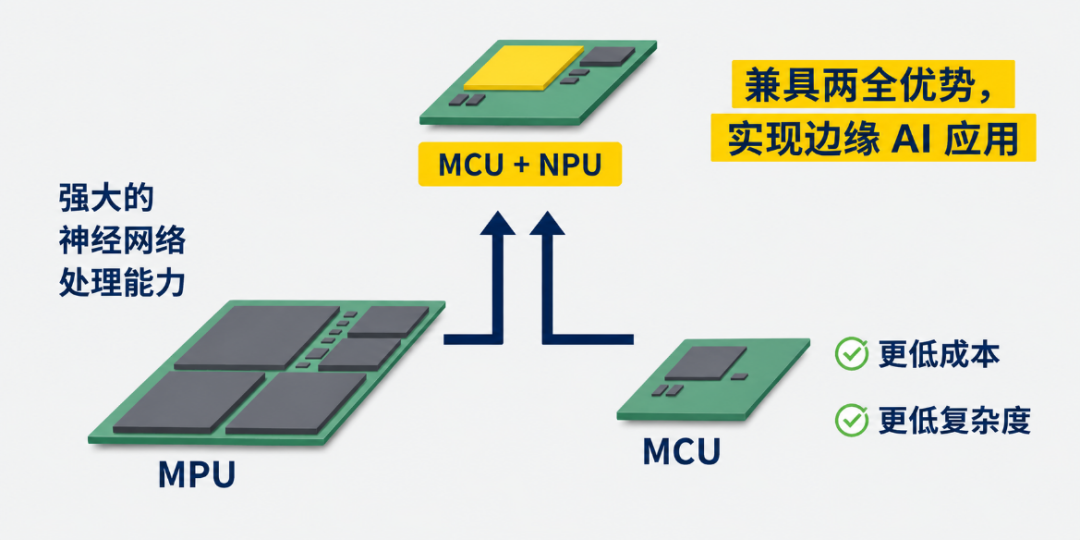
图:边缘AI硬件架构对比
——MCU+NPU兼具性能与成本双重优势
相较于纯MCU,集成NPU的AI MCU大幅提升了神经网络算力;相较于MPU,它保持了更低的系统复杂度和BOM成本,是边缘AI规模化落地的理想选择。
三、瑞萨的AI MCU布局:产品矩阵与生态赋能
作为全球领先的微控制器供应商,瑞萨电子敏锐地捕捉到这一趋势,并构建了覆盖从低到高算力需求的完整AI MCU产品矩阵。瑞萨的解题思路并非提供单一芯片,而是通过“芯片+工具+生态”的全链路布局,助力端侧AI从概念走向规模化落地。
3.1 RA8P1:
高性能AI MCU的旗舰标杆
核心亮点:RA8P1是瑞萨首款搭载高性能Arm Cortex-M85及Helium矢量扩展,并集成Ethos-U55 NPU的32位AI加速MCU。
为什么MRAM重要?与闪存相比,MRAM具备更快的写入速度、更高的耐久性和更强的数据保持能力。对于需要频繁更新AI模型或记录运行数据的场景,MRAM的优势尤为突出。
专为AI设计的外设:
视觉AI:16位摄像头接口(CEU),支持高达500万像素图像传感器;MIPI-CSI2接口
语音AI:I2S和PDM接口
显示:并行RGB和MIPI-DSI接口,2D绘图引擎
连接:千兆以太网、TSN交换机、USB2.0 HS/FS、CAN-FD
典型AI应用:
图像分类(ResNet8、MobileNet v2/v3)
关键词识别(DS-CNN)
对象检测(Yolo_fastest、Yolov8N)
工业异常检测
3.2 异构计算的精髓:
CPU与NPU并行处理
RA8P1的架构设计体现了现代AI MCU的精髓。Arm Ethos-U55在RA8P1中是作为一个外设模块实现,拥有独立的控制块和DMA通道,能够使用CPU程序提供的命令列表独立执行操作。这种设计支持CPU与NPU之间的并行处理——NPU执行AI推理的同时,CPU可同步执行电机控制、通信等其他任务。
3.3 RA8系列:
从“旗舰”到“全系”
RA8系列已发展为涵盖多个产品群的完整家族:
RA8系列覆盖AI推理、工业自动化、图形视觉以及主流通用控制四大方向。其中,RA8T2虽未集成独立NPU,但其Helium矢量扩展技术同样能够显著加速DSP和ML计算,相比传统Cortex-M7提升达4倍,是电机控制与工业自动化中实现AI异常检测的理想选择。
3.4 超低功耗系列:
让AI无处不在
对于电池供电的传感器节点和始终在线的感知设备,瑞萨的RL78/G23与RA2系列提供极致低功耗的AI部署方案。
RL78/G23:运行功耗低至41μA/MHz,停止电流低至210nA,内置丰富的模拟外设与电容式触摸感应单元。
RA2系列:基于Arm Cortex-M23内核的入门级32位MCU,工作电流低至64μA/MHz,软件待机电流仅250nA,部分型号集成24位Σ-ΔADC,适用于高精度传感器信号处理。
通过在超低功耗MCU上部署轻量级AI模型(TinyML),可实现始终在线的振动监测、关键词唤醒、简单异常检测等功能——让AI真正渗透到每一个角落。瑞萨提供配套的软件工具,可自动优化和部署模型至这些资源受限的器件。
四、不止于芯片:瑞萨的AI MCU开发生态
4.1 Reality AI Tools:
信号处理的利器
Reality AI Tools是瑞萨面向边缘端侧的旗舰级AI/ML软件平台,采用云端开发环境,将高级信号处理与机器学习技术深度融合。
它专为传感器信号处理场景优化,可帮助工程师快速构建、优化并部署适配加速度、振动、声音、电气信号等多类型传感器的端侧AI模型——即使开发者没有专业的AI建模经验,也能通过自动化工具完成特征探索、模型训练与代码优化。
Reality AI Utilities则是一套专为端到端边缘AI开发打造的工具集,可作为e²studio的插件使用,也可在Keil、IAR、CS+等其他主流IDE中独立运行。它支持从任何瑞萨MCU项目中实时收集数据,直接上传到Reality AI Tools进行模型创建与优化。
4.2 e-AI Translator:
一键部署成熟模型
对于已有成熟模型的开发者,e-AI Translator提供了一条高效路径:一键将PyTorch、TensorFlow等主流框架训练好的模型转换为MCU可运行的优化C代码,并可提前评估目标硬件上的资源占用与推理性能,让部署过程透明可控。
4.3 RUHMI与AI Navigator:
简化AI开发流程
RUHMI(Robust Unified Heterogenous Model Integration)是瑞萨高度优化的AI软件平台,提供AI开发、模型优化和转换所需的全套工具,并与e² studio完全集成,为异构计算(CPU+NPU)场景提供统一的软件接口。
AI Navigator是e²studio中的一套GUI插件,通过图形化界面引导AI应用的开发流程,支持以最短步骤在瑞萨MCU上实现AI应用的部署——从模型导入、量化配置到代码生成,全程可视化操作。
4.4 全栈生态,
加速规模化落地
瑞萨构建了完善的AI MCU开发生态:
AI HUB资源平台,提供丰富的预训练模型、应用笔记与参考案例
Renesas AI Model Deployer(瑞萨AI模型部署工具)支持对接NVIDIA TAO生态,实现跨平台模型适配与高效部署
收购Irida Labs,强化视觉AI软件算法能力
推出Renesas 365云端开发平台,统一从系统探索到生命周期管理的全流程
瑞萨已推动AI与传感器、电机控制等关键技术深度融合,AI MCU方案覆盖家电、工业、智慧城市等主流领域。
五、实战展望:如何基于瑞萨AI MCU开启边缘AI项目?
对于开发者而言,选择瑞萨AI MCU可以遵循以下路径:
需求定义:明确AI任务(分类、检测、识别)、性能要求(帧率、精度)、功耗预算和成本目标。
产品选型:
AI视觉与高性能推理:首选RA8P1
电机控制+AI异常检测:考虑RA8T2
图形化HMI+边缘AI:考虑RA8D2
超低功耗传感与TinyML:考察RL78/G23或RA2系列
开发启动:
1.访问瑞萨官网,获取对应型号的评估套件(如EK-RA8P1)
2.利用瑞萨的灵活软件包(FSP)快速构建基础工程
3.根据自身AI能力选择工具链:
无AI建模经验→使用Reality AI Tools自动化构建模型
已有成熟模型→使用e-AI Translator一键转换部署
4.利用AI Navigator在e²studio中完成从导入到部署的全流程可视化操作
5.在性能、精度和资源占用间迭代优化,最终集成到量产固件中
NPU的兴起标志着AI计算进入了专用化时代,而AI MCU的蓬勃发展则是边缘智能规模化落地的关键基石。瑞萨电子通过其多层次、全覆盖的产品战略,以及从硬件到软件的全面赋能,正稳稳地站在这一浪潮之巅。
从集成Ethos-U55NPU、实现256GOPS AI性能的RA8P1,到搭载Helium技术的RA8T2工业AI方案,再到支持TinyML的RL78/G23超低功耗系列——瑞萨AI MCU产品矩阵已全面覆盖从极致低功耗到高性能AI加速的各种场景。加之Reality AI Tools、e-AI Translator、RUHMI等完整的工具链与开发生态,瑞萨正在为从智能家居到工业自动化、从可穿戴设备到智慧城市的广泛场景,提供从芯片到应用的全链路解决方案。
未来,随着算法模型的进一步轻量化与硬件能效的持续提升,AI MCU将渗透到更多我们想象不到的角落,真正实现“万物皆可智能”。而选择像瑞萨这样拥有完整芯片+工具+生态解决方案的合作伙伴,无疑能让开发者与企业在通往智能未来的道路上,行得更稳、走得更远。